Bu yazıda
Nemotron Bolt E4B Erişime Açıldı
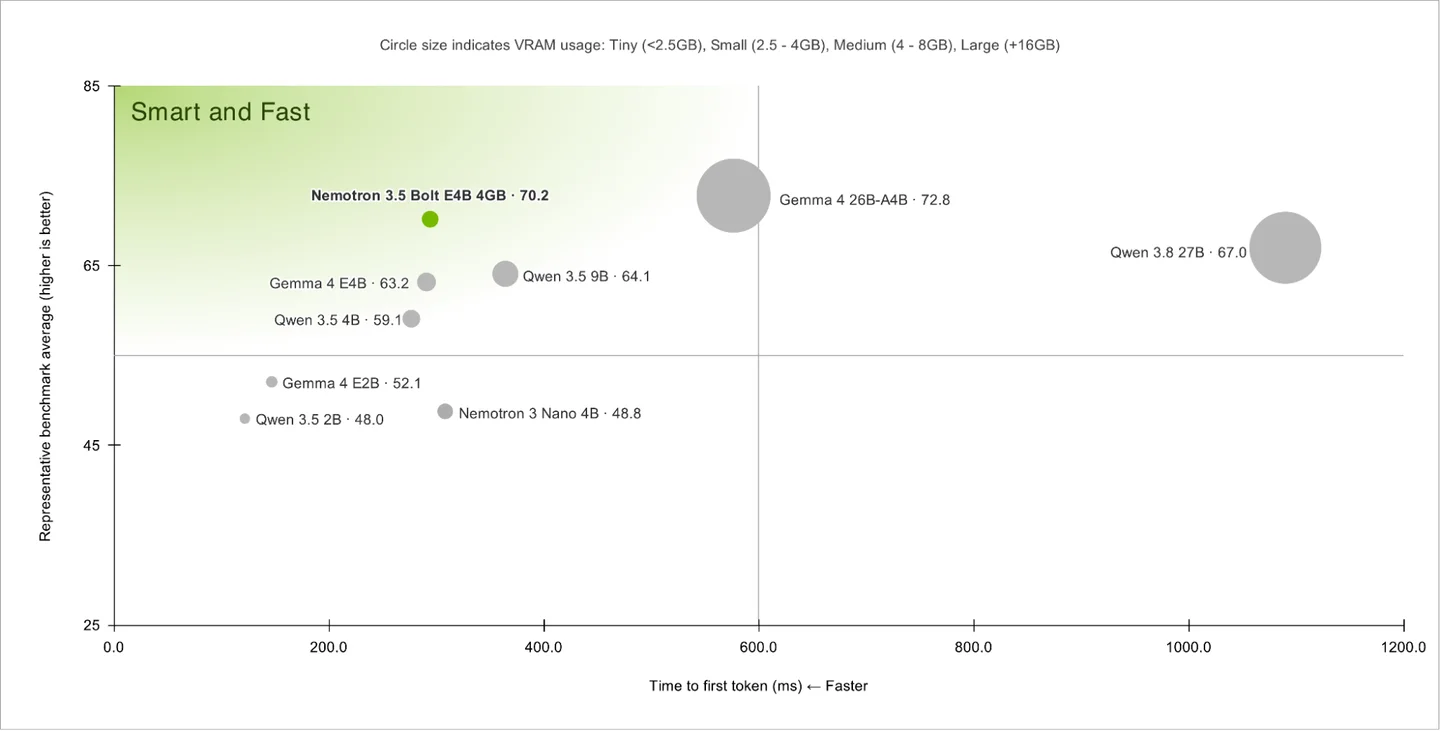
NVIDIA, Nemotron 3.5 ailesinin yeni üyesi olan Bolt E4B modelini 23 Ekim itibarıyla geliştiricilerin kullanımına sundu. Temelde sesli asistanlar, etkileşimli karakterler ve yerel cihaz üzerinde çalışan sohbet ajanları için özelleştirilen bu model, Google'ın Gemma 4 E4B mimarisi temel alınarak NVIDIA'nın özel eğitim çalışmalarıyla geliştirildi. Model, kullanıcılara konuşmayı doğal ve kısa tutma odağının yanı sıra, karmaşık görevler için devreye alınabilen akıl yürütme seçenekleri sunuyor.
Araç Kullanımı ve Bağlam Desteği
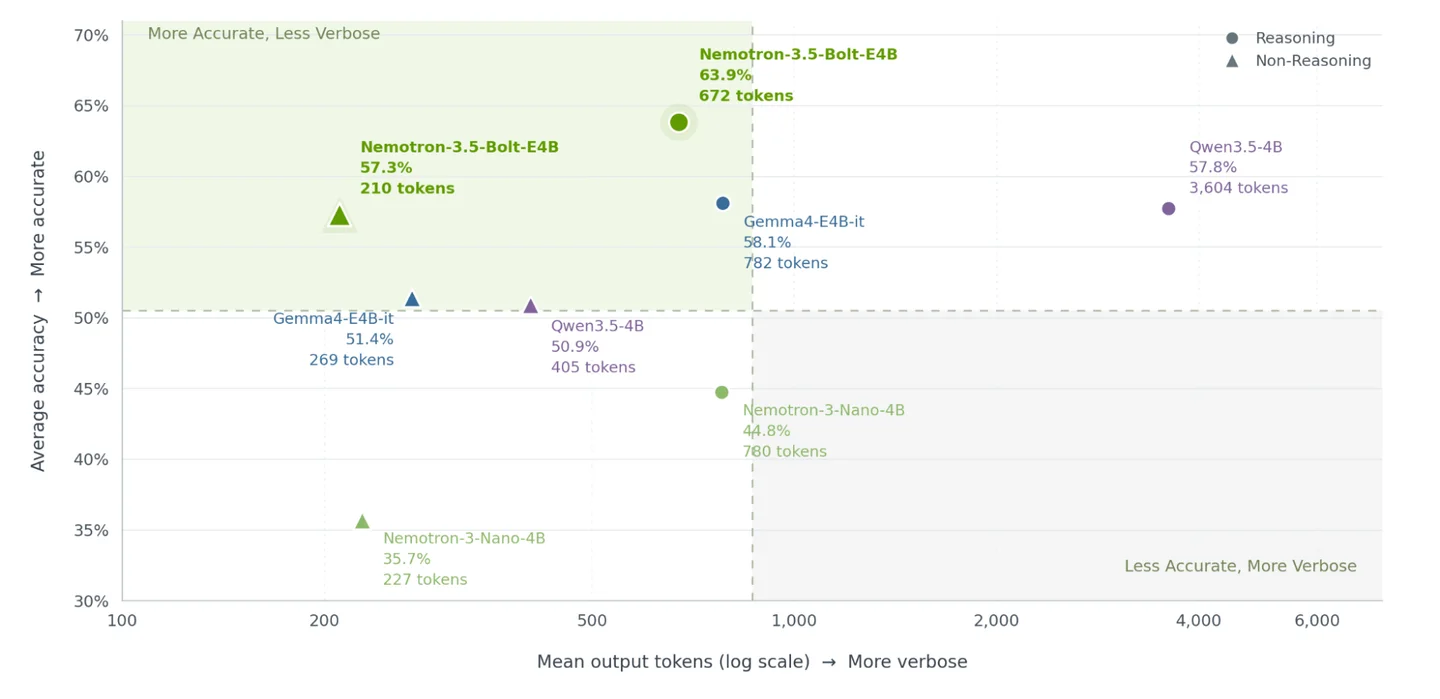
Bolt E4B, birden fazla konuşma adımında görev yürütebilme yeteneğiyle öne çıkıyor. Model, uygulama izinleri dahilinde API işlevlerini çağırarak kullanıcı adına işlem yapabiliyor; ancak bu süreç, uygulamanın sunduğu entegrasyonla sınırlı kalıyor. NVIDIA, 64 bin tokenlık geniş bir bağlam desteği sunarak modelin konuşma geçmişi, sistem yönergeleri ve dış verileri bir arada işlemesine olanak tanıyor. Şirket, önceki Nano 4B modellerine kıyasla %40 daha yüksek sonuçlar ve %80'e varan çıktı verimliliği bildirdi.
Bellek Kullanımı ve Teknik Performans
Modelin 4 GB bellek hedefi, her senaryo için sabit bir kuralı temsil etmiyor. RTX 5070 üzerinde yapılan testlerde, kısa girdilerde bellek kullanımı 3,5 GB seviyesindeyken, daha uzun bağlam gerektiren senaryolarda bu değer 4,3 GB'a çıkabiliyor. Çıkarım performansı, kullanılan nicemleme yöntemine ve CUDA desteği sunan yazılımlara göre değişiklik gösteriyor. NVIDIA, geliştiricilere Hugging Face, Ollama ve Jetson AI Lab gibi çeşitli platformlar üzerinden modelin yerel olarak dağıtılmasını ve çalıştırılmasını öneriyor.